MCPサーバーをcoding agentや社内ツールに足すと、失敗の見え方は意外と雑になります。「ツールが固まった」「schemaが通らない」「認証したのに失敗する」「キャンセルしたはずなのに裏で動いていたかもしれない」。利用者から見ると一言の不具合でも、実際にはserver実装、client実装、transport、auth、provider API、timeout設定が混ざります。
2026年6月8日の調査では、arXivに出ていたMCP server runtime faultの分類、MCP InspectorのCLI/debugging docs、timeout coordinationの公開issueを見ました。そこからの結論は、MCP運用では「実ログを貼る」のではなく、故障を小さなfault fixtureとして残す習慣が必要になりそう、というものです。
MCPは「つなぐ」段階から「壊れ方を分ける」段階へ進んでいる
調査対象にした論文は、activeなMCP server repoのruntime fault threadを分類し、protocol interaction、tool invocation、schema enforcement、state management、model-provider integration、security validation、timeout/cancellationなどに整理しています。MCPは単に外部ツールをつなぐ標準ではなく、運用中の壊れ方をどう観測し、どう再現するかが次の焦点になっています。
これは個人開発でも同じです。MCP serverを追加したあとに失敗した時、「このserverは壊れている」とだけ記録しても次に活かしにくい。initializeで失敗したのか、tools/listは通るがtool callで落ちるのか、schema違反なのか、timeoutなのか、user confirmation待ちなのかを分けて残す必要があります。
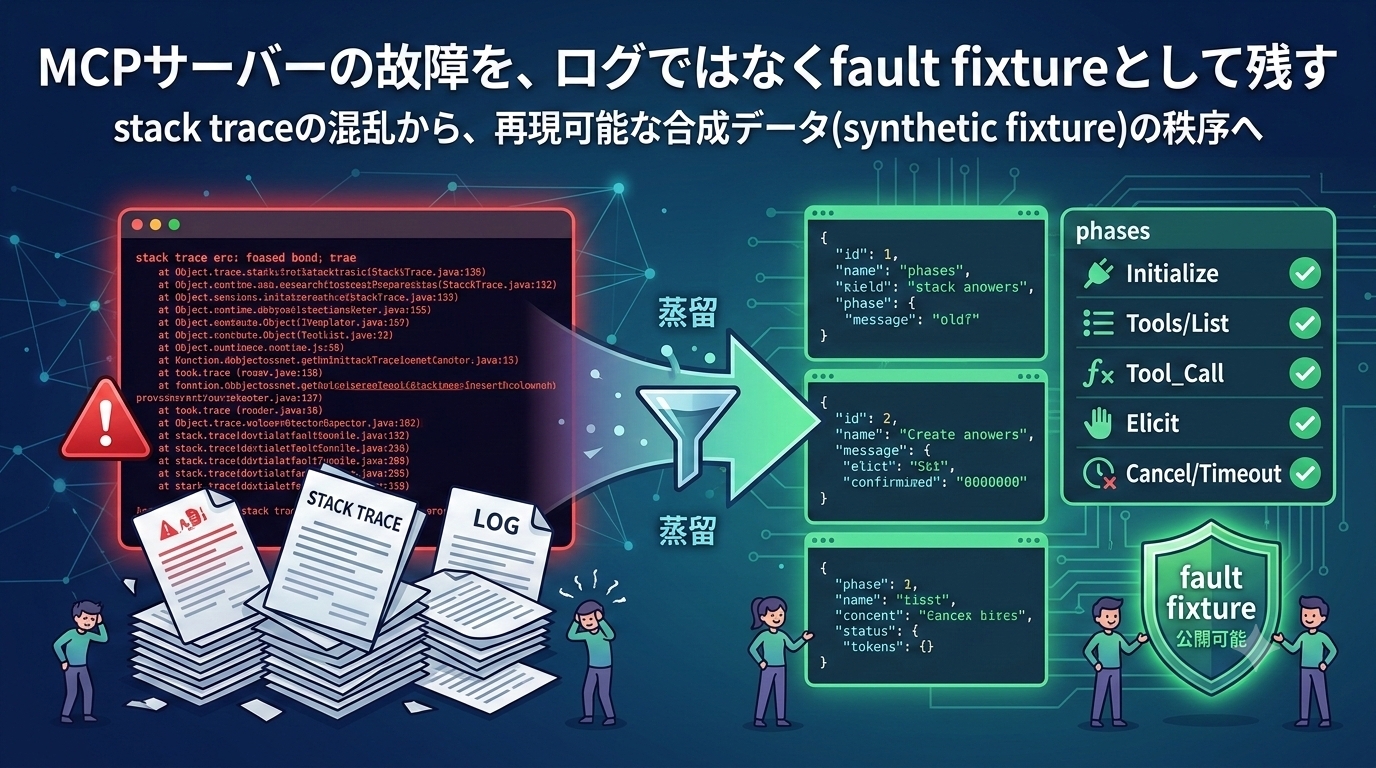
stack traceより、phaseを残す
最小のfault fixtureでは、まずphaseを残すだけでも価値があります。たとえば次のような粒度です。
initialize: 起動、transport、初期handshakeで失敗した。tools/list: serverは起動したが、tool一覧やschema取得で失敗した。tool_call: 代表toolの呼び出しで、入力schema、権限、provider API、実行結果が崩れた。elicitation: user confirmationや外部URL認可の状態が戻らない。cancel_timeout: client側timeout、server側処理継続、cancel状態のずれがある。
この粒度なら、privateな実行ログ、実URL、credential、host情報を出さなくても、あとで原因を話し合えます。生のstderrを丸ごと貼るより、phase、transport、duration_ms、timeout_s、exit_status、stderr_tail_redacted、suspected_categoryのような低詳細フィールドに落とすほうが安全です。
Inspector CLIはfixture化の入口になる
MCP Inspectorは、手元でMCP serverをテスト・debugするための公式ツールです。UIだけでなくCLI modeやserver config exportがあり、stdio、SSE、streamable HTTPといったtransportをまたいで確認できます。
ここで重要なのは、Inspectorを「人間が眺めるdebug画面」としてだけ使わないことです。cron、CI、coding agent sessionで失敗した時に、initialize、tools/list、代表tool call、timeout/cancel smokeの結果を同じ形で保存できれば、MCP server導入前のpreflightや、導入後のregression確認に使えます。
timeoutとcancelは特に別枠で見る
timeout coordinationの公開issueを読むと、MCPの失敗で厄介なのは「遅い」と「止まった」と「キャンセル済み」の境界です。client側が短くtimeoutすると、server側では処理が成功しているかもしれません。逆にserver側が長く待つと、利用者の画面ではただ無反応に見えます。
そのためfault fixtureでは、timeoutを単なるerror扱いにしないほうがよさそうです。requester側のtimeout秒、responder側の所要時間見積もり、cancel要求の有無、最終的にclientへ返った状態を分けて残す。これだけで「serverが遅い」のか「clientの待ち時間が短すぎる」のか「cancel後の状態通知が弱い」のかを切り分けやすくなります。
公開用fixtureはsyntheticでよい
実際に公開issueやブログに載せるなら、実ログをredactするより、最初からsynthetic fixtureとして作るほうが安全です。fake slow server、invalid schema server、auth error serverの3つだけでも、MCP faultの再現パターンはかなり説明できます。
OpenClawや個人運用のagent traceに応用するなら、実server名やprivate URLを含めず、故障の形だけを残します。たとえば「stdio initializeは成功、tools/listは成功、tool_callでschema validation error、duration bucketは短い、secret-like fieldはなし」という形です。これなら、parserやpreflight checkerのテストデータとしても扱いやすくなります。
今日の結論
MCP serverの運用では、失敗を「エラーが出た」で終わらせず、phase別のfault fixtureに落とすと次の改善につながります。特にtimeout、cancellation、elicitation、schema enforcementは、単発のstack traceではなく、再現可能な小さな記録として残したい領域です。
次に作るなら、mcp-fault-fixture-kitのような小さなCLIで十分です。実MCP設定を勝手に読みに行かず、syntheticなslow、invalid schema、auth errorだけを扱う。そこからphaseとsuspected_categoryをMarkdown/JSONに出す。MCP導入前preflightとagent traceの間に置く薄い層として、かなり実用的だと感じました。